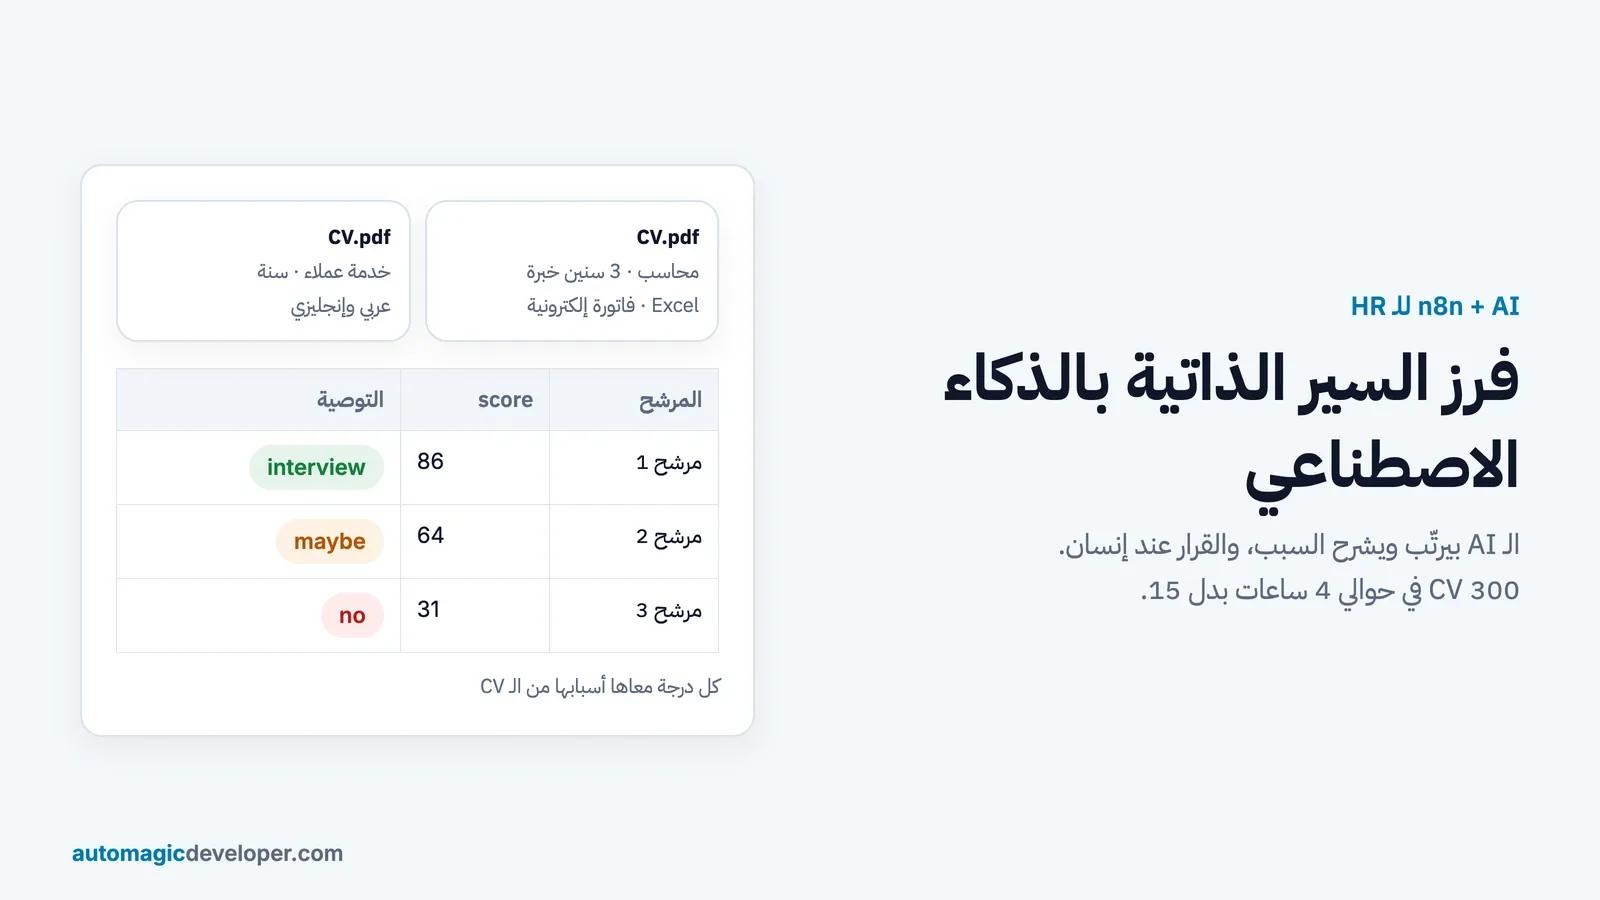
إعلان وظيفة محاسب واحد في القاهرة ممكن يجيب 300 CV في أسبوع. لو حد من HR بياخد 3 دقايق بس في الفرزة الأولى لكل CV، ده 15 ساعة قبل أول مقابلة. فرز السير الذاتية بالذكاء الاصطناعي بيختصر الـ 15 ساعة دي لحوالي 4، بتكلفة AI أقل من دولار. وفي نفس الوقت ممكن يعمل ظلم من غير ما حد ياخد باله لو اتبنى غلط.
في المقال ده هبني workflow بـ n8n بيستلم الـ CV، يطلّع النص من الـ PDF، يقيّمه على شروط الوظيفة المكتوبة، ويحط النتيجة والأسباب في Google Sheets، ويسأل مسؤول التوظيف قبل أي دعوة لمقابلة. الـ AI بيرتّب ويشرح، والقرار بتاع إنسان. ونفس الـ workflow ده جزء من المحاضرة 18 في الدبلومة.
المحتوى
- الـ workflow في صورة واحدة
- الخطوة 1: استلام الـ CV
- الخطوة 2: استخراج النص من الـ PDF
- الخطوة 3: الـ rubric والتقييم بـ JSON
- الخطوة 4: الشيت وموافقة مسؤول التوظيف
- حسبة العائد: الوقت والفلوس
- قواعد العدالة في فرز السير الذاتية بالذكاء الاصطناعي
- الخصوصية
- أسئلة شائعة
الـ workflow في صورة واحدة
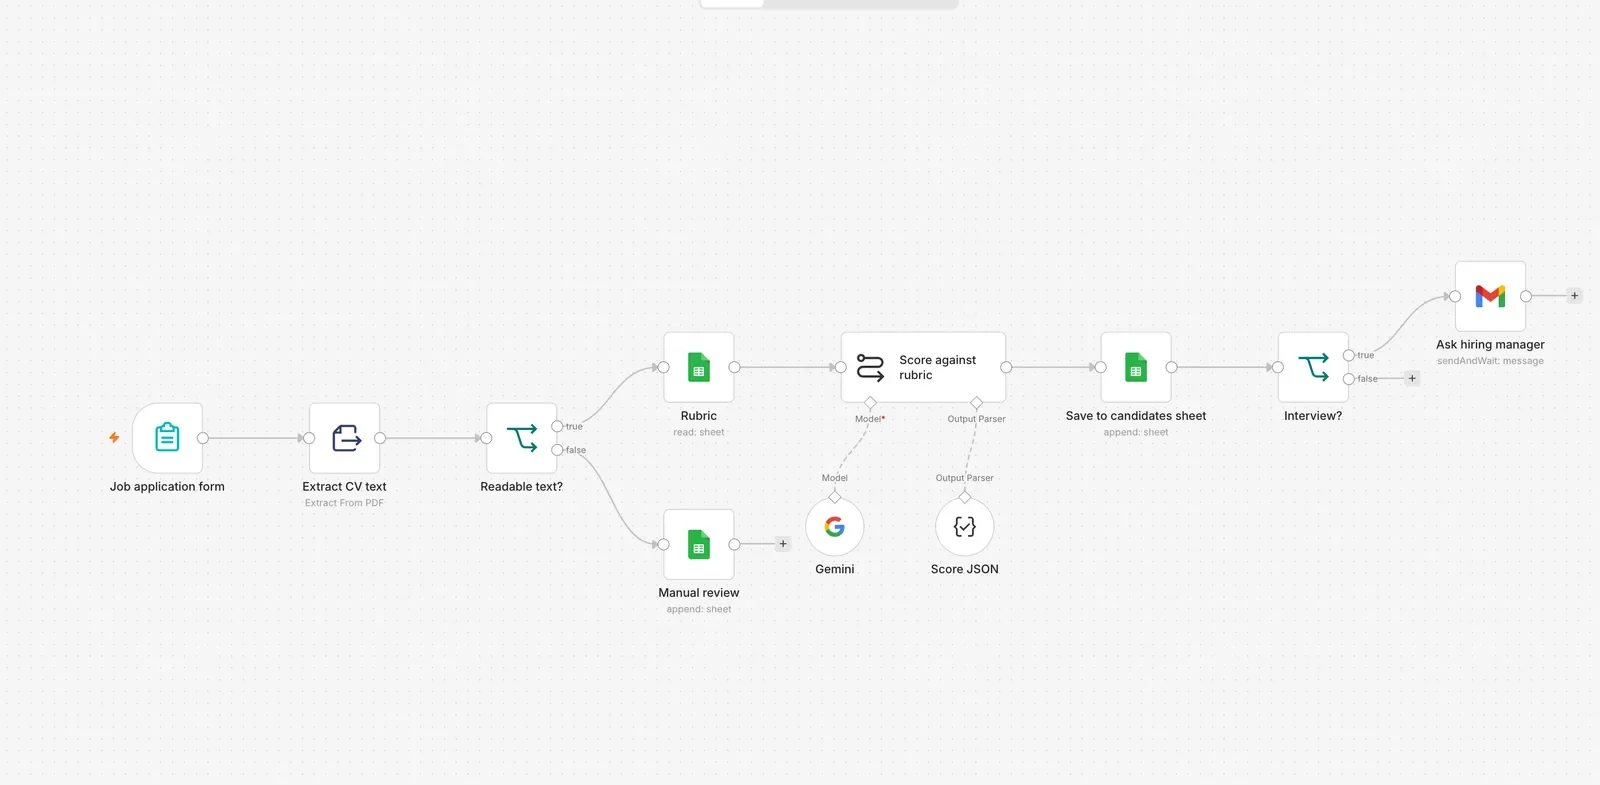
خد مثالين هنرجعلهم طول المقال:
- فريق HR في شركة في القاهرة بيعيّن محاسب. الشروط: بكالوريوس تجارة، سنتين خبرة على الأقل، Excel كويس. ميزة إضافية: خبرة في الفاتورة الإلكترونية.
- شركة في الرياض بتعيّن موظف خدمة عملاء. الشروط: عربي وإنجليزي كويسين، سنة خبرة في خدمة العملاء. ميزة إضافية: شغل قبل كده على متجر إلكتروني.
الخطوة 1: استلام الـ CV
الطريقة الأسهل: n8n Form. الـ n8n Form Trigger بيعملك فورم برابط تحطه في إعلان الوظيفة. ضيف حقول: الاسم، الإيميل، الوظيفة (Dropdown)، وحقل Element Type بتاعه File للـ CV.
خلّي بالك من تفصيلة بتوقع ناس كتير: الملف بيوصل للـ workflow كـ binary باسم الحقل. لو سمّيت الحقل بالعربي، n8n بيحوّل الحروف العربي لـ _ والاسم بيبوظ. اكتب العنوان اللي المتقدم بيشوفه بالعربي براحتك، بس خلّي Field Name إنجليزي، مثلاً cv.
واللي مش هتسأل عنه مهم زي اللي هتسأل عنه. الفورم مايطلبش سن، ولا نوع، ولا ديانة، ولا صورة. اللي مش محتاجه ماتجمعوش.
الطريقة التانية: Gmail Trigger. لو الـ CVs بتيجي على إيميل التوظيف، استخدم Gmail Trigger مع Search زي has:attachment filename:pdf. الـ trigger بيعمل polling كل فترة إنت بتحددها. عشان المرفق نفسه يوصل، اقفل Simplify، وفي Options ضيف Download Attachments وفعّله. المرفق هيوصل باسم attachment_0.
الخطوة 2: استخراج النص من الـ PDF
الـ Extract from File node على عملية Extract From PDF بيحوّل الملف لنص في حقل text. غيّر Input Binary Field من data (القيمة الافتراضية) لاسم الملف عندك: cv لو من الفورم، أو attachment_0 لو من Gmail. من غير الخطوة دي الـ workflow بيقع من أول تشغيل.
الـ node ده بيقرا النص المكتوب جوا الـ PDF، ومفيهوش OCR. لو حد بعت CV متصوّر (صورة متحولة PDF)، النص هيطلع فاضي أو شبه فاضي. عشان كده فيه If بعدها: لو طول النص أقل من 200 حرف، الـ CV يروح شيت مراجعة يدوية بدل الـ AI. ده أعدل من إن المرشح ياخد درجة وحشة بسبب شكل الملف.
الخطوة 3: الـ rubric والتقييم بـ JSON
ده قلب الـ workflow. الـ AI مش هيعرف الوظيفة محتاجة إيه إلا لو إنت كتبتها. الـ rubric بيتكتب مرة واحدة لكل وظيفة، ويتراجع مع مدير القسم.
الشروط محطوطة في شيت صغير فيه صف لكل وظيفة، و Google Sheets node على عملية Get Row(s) اسمه Rubric بيجيب الصف. ضيف فيه Filter على عمود job يساوي الوظيفة اللي المتقدم اختارها في الفورم، وإلا هيرجّع كل الوظايف والتقييم هيتكرر لكل صف. كده مدير القسم يعدّل الشروط من الشيت من غير ما يلمس الـ workflow.
بعدها Basic LLM Chain متوصّل بـ chat model (أنا مستخدم Gemini في الصورة، وينفع OpenAI أو غيره). خلّي الـ prompt على Define below، وفعّل Require Specific Output Format ووصّل Structured Output Parser على Generate from JSON Example. كده الموديل مجبر يرجّع JSON بالشكل ده، و n8n بيعتبر كل حقل فيه إجباري:
{
  "must_haves": [
    { "requirement": "بكالوريوس تجارة", "met": true, "evidence": "بكالوريوس تجارة جامعة عين شمس 2021" }
  ],
  "nice_to_haves": [
    { "requirement": "خبرة في الفاتورة الإلكترونية", "met": false, "evidence": "" }
  ],
  "score": 72,
  "recommendation": "interview",
  "reasons": "مستوفي الشروط الأساسية الثلاثة، ومفيش دليل على خبرة الفاتورة الإلكترونية."
}
والـ prompt:
إنت بتساعد فريق توظيف يرتّب المتقدمين. إنت مش بتاخد قرار.

الوظيفة: {{ $('Rubric').item.json.job }}

الشروط الأساسية (must-haves):
{{ $('Rubric').item.json.must_haves }}

المميزات الإضافية (nice-to-haves):
{{ $('Rubric').item.json.nice_to_haves }}

القواعد:
- قيّم على الشروط المكتوبة فوق بس.
- لكل شرط، هات الدليل من نص الـ CV حرفياً. لو مفيش دليل، met = false.
- تجاهل تماماً: السن، تاريخ الميلاد، النوع، الديانة، الحالة الاجتماعية، الجنسية، الصورة، اسم الجامعة كمقياس للمستوى.
- score من 0 لـ 100: الشروط الأساسية 80%، والمميزات 20%.
- recommendation واحدة من: interview, maybe, no.
- لو النص ناقص أو مش واضح، recommendation = maybe واكتب السبب.

نص الـ CV:
{{ $('Extract CV text').item.json.text }}
الأسماء اللي جوا $('...') هي أسماء الـ nodes عندك، فغيّرها لو سمّيتها حاجة تانية. ولو عايز بديل للـ chain، n8n عنده Information Extractor node بيطلّع بيانات منظمة من النص بنفس الفكرة.
الخطوة 4: الشيت وموافقة مسؤول التوظيف
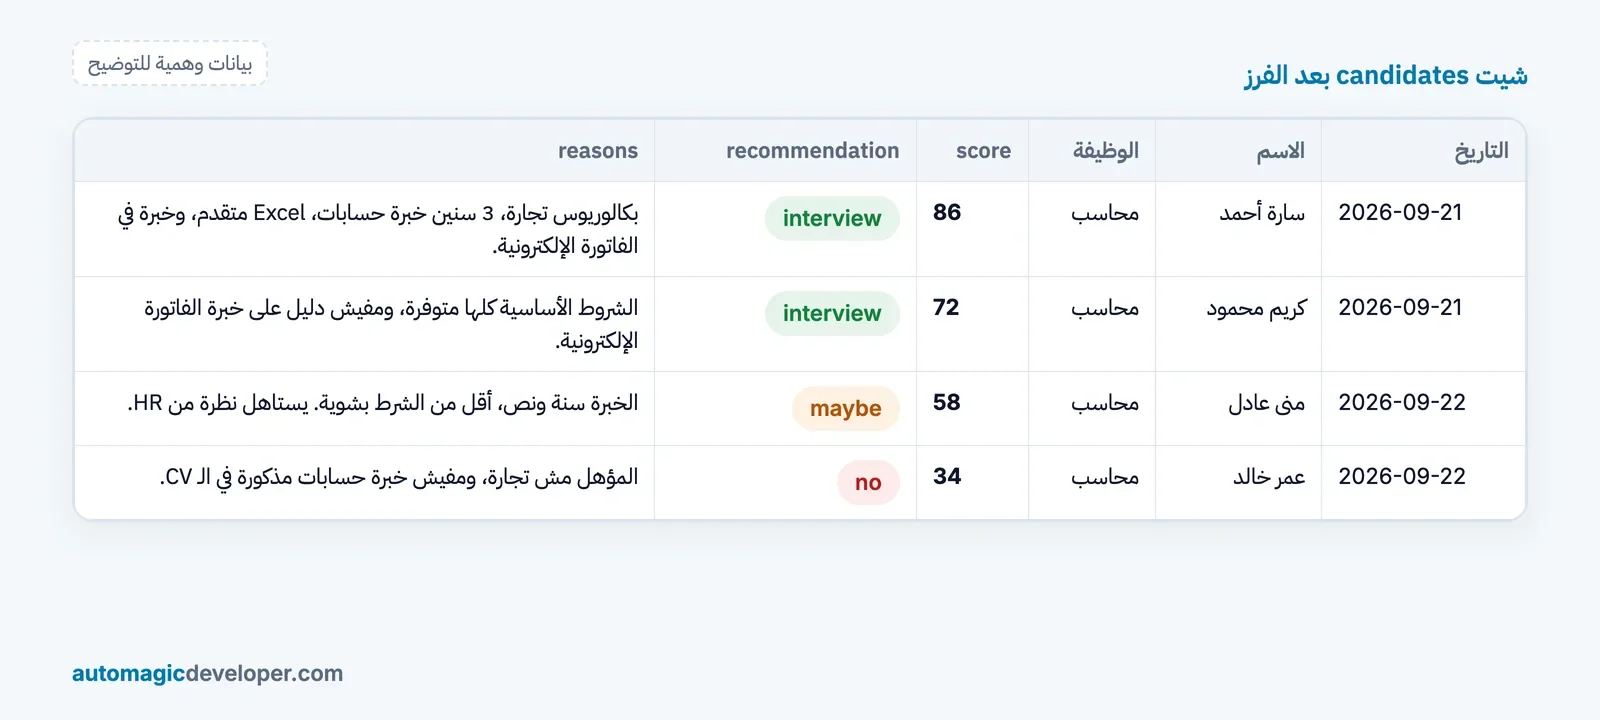
Google Sheets على Append Row بيضيف صف لكل مرشح: التاريخ، الاسم، الإيميل، الوظيفة، الـ score، الـ recommendation، والـ reasons. الـ HR بيفتح الشيت ويرتّب بالـ score، وكل رقم جنبه السبب.
بعدها If: لو recommendation = interview، الـ Gmail node على عملية Send and Wait for Response مع Response Type = Approval بيبعت لمسؤول التوظيف إيميل فيه الاسم والأسباب وزرار موافقة. الـ workflow بيستنى لحد ما يدوس، وبعدها يكمّل ويبعت دعوة المقابلة. الإيميل بيروح للمسؤول مش للمرشح، ومفيش رفض أوتوماتيك لأي حد من غير ما إنسان يشوف الـ CV.
حسبة العائد: الوقت والفلوس
دي حسبة لإعلان وظيفة واحد. الأرقام افتراضات للتوضيح، فحط أرقامك انت مكانها:
| البند | من غير الـ workflow | بالـ workflow |
|---|---|---|
| CVs وصلت | 300 | 300 |
| الفرزة الأولى | 300 × 3 دقايق = 15 ساعة | الـ AI بيرتّب الكل |
| مراجعة إنسان | ضمن الـ 15 ساعة | 40 CV (interview و maybe) × 5 دقايق = 3.3 ساعة |
| عينة من اللي اترفضوا | مفيش | 10 CVs = نص ساعة |
| الوقت الكلي | 15 ساعة | حوالي 4 ساعات |
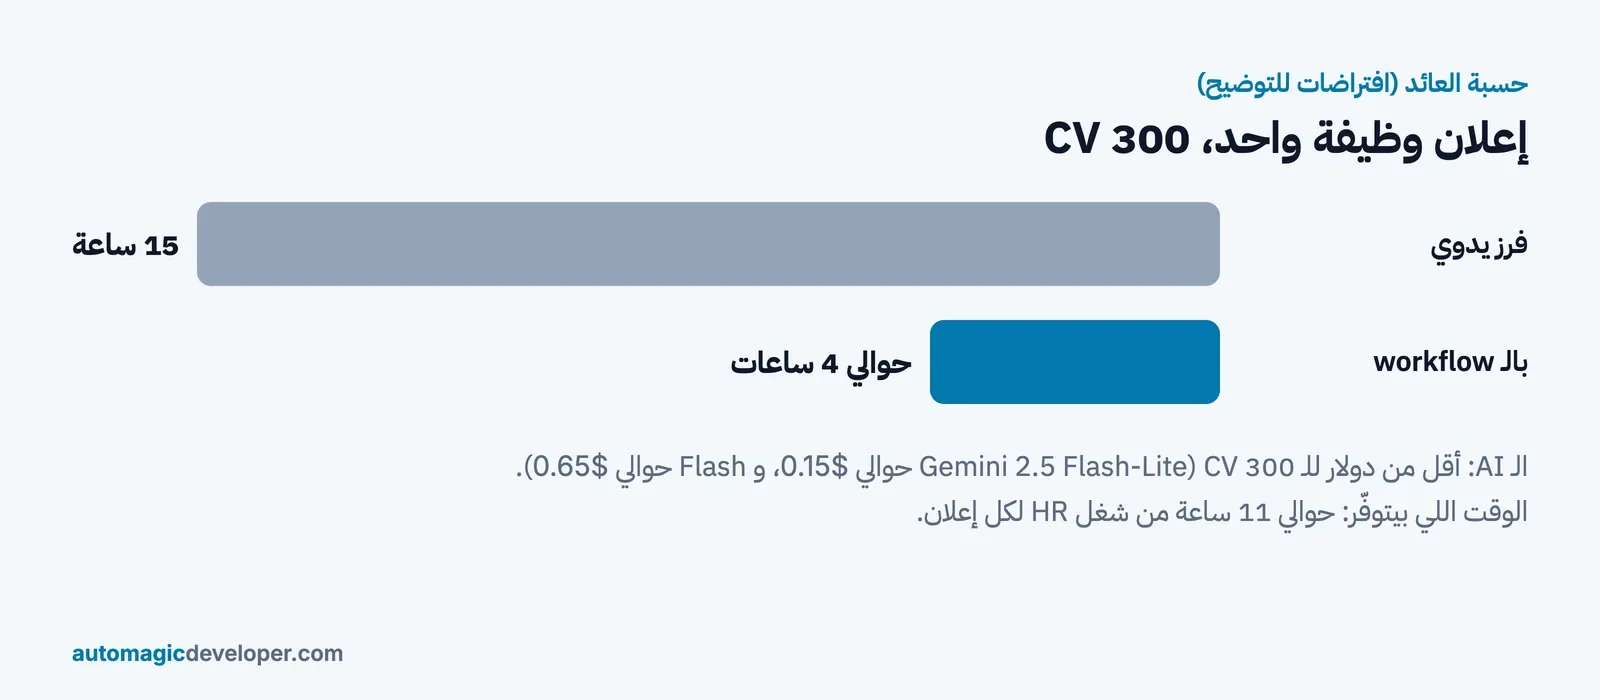
تكلفة الـ AI. CV من صفحتين مع الـ prompt والـ rubric حوالي 3,000 token داخل، والـ JSON حوالي 500 token خارج. بأسعار Gemini على الـ paid tier في سبتمبر 2026:
Gemini 2.5 Flash-Lite (0.10$ داخل / 0.40$ خارج لكل مليون token):
  3,000 × 0.10 / 1,000,000 = 0.0003$
    500 × 0.40 / 1,000,000 = 0.0002$
  لكل CV ≈ 0.0005$    لكل 300 CV ≈ 0.15$

Gemini 2.5 Flash (0.30$ / 2.50$):
  لكل CV ≈ 0.002$     لكل 300 CV ≈ 0.65$
يعني الـ AI بيكلّف أقل من دولار للإعلان كله، والوقت اللي اتوفّر حوالي 11 ساعة من شغل HR. الموديلات اللي بتفكّر قبل ما ترد (thinking) بتحسب التفكير كـ output، فالتكلفة ممكن تتضاعف مرتين أو تلاتة، وبرضه هتفضل بالسنتات. الأسعار بتتغيّر، راجع صفحة أسعار Gemini قبل ما تعتمد على الرقم.
المعادلة اللي تحسب بيها عندك:
الساعات اللي بتتوفّر = (عدد الـ CVs × دقايق الفرزة الأولى) ÷ 60
                     − (عدد اللي هتراجعهم × دقايق المراجعة) ÷ 60
قواعد العدالة في فرز السير الذاتية بالذكاء الاصطناعي
دي القواعد اللي بطبّقها في كل workflow زي ده وبعلّمها للطلبة:
- الـ AI بيرتّب، إنسان بيقرر. مفيش مرشح يترفض من غير ما حد من HR يشوف الـ CV بعينه.
- البيانات الشخصية برا التقييم. السن والنوع والديانة والصورة والحالة الاجتماعية مالهمش مكان في الـ rubric، ومكتوب في الـ prompt إنه يتجاهلهم. والأحسن إنك ماتجمعهمش من الأول.
- الشروط القانونية بإيد إنسان. لو الوظيفة ليها شرط قانوني، زي تصريح العمل أو نوع الإقامة في السعودية، ده يبقى سؤال صريح في الفورم ويتراجع بإيد HR، والـ AI مايستنتجهوش من الاسم أو الجنسية.
- الأسباب مكتوبة. كل score معاه أدلة من الـ CV. لو الأسباب مش مقنعة، الـ rubric محتاج يتعدّل.
- اختبر الانحياز قبل التشغيل. خد نفس الـ CV وغيّر الاسم بس (اسم ولد واسم بنت، أسماء من بلاد مختلفة) وشوف الـ score اتغيّر ولا لأ. لو اتغيّر، فيه مشكلة لازم تتحل الأول.
- راجع عينة من الـ "no" كل أسبوع. افتح 5 أو 10 CVs من اللي الـ AI اداها درجة قليلة. لو لقيت حد كويس اترفض، ارجع للـ rubric.
الخصوصية
الـ CV فيه بيانات شخصية: اسم، تليفون، عنوان، وأحياناً رقم قومي. في السعودية نظام حماية البيانات الشخصية مطبّق بالكامل من سبتمبر 2024، وفي مصر اللائحة التنفيذية لقانون حماية البيانات الشخصية صدرت في نوفمبر 2025 بمهلة سنة لتوفيق الأوضاع. اسأل القانوني عندكم عن التفاصيل. عملياً:
- اختار مزوّد الـ AI بعناية. في الـ free tier بتاع Gemini API، جوجل بتقول إن المحتوى بيُستخدم لتحسين منتجاتها، وفي الـ paid tier لأ. الـ CVs الحقيقية مكانها الـ paid tier.
- ابعت للموديل النص اللي محتاجه بس. لو تقدر تشيل التليفون والعنوان من النص قبل ما يروح للـ AI، شيلهم.
- حدد مدة الاحتفاظ. الـ CVs والصفوف في الشيت تتمسح بعد مدة واضحة (6 شهور مثلاً)، وده ممكن يبقى workflow تاني بيشتغل بجدول.
- الصلاحيات. الشيت يتشارك مع فريق التوظيف بس.
- قول للمتقدمين. جملة في الفورم إن فيه أداة AI بتساعد في الترتيب الأولي، وإن إنسان بيراجع كل طلب.
نفس الفكرة بتنفع للفواتير والإيصالات، وده مشروح في قراءة الفواتير بالذكاء الاصطناعي. ولو عايز تعرف تشغيل الـ workflow ده هيكلّفك كام على n8n نفسه، اقرا هل n8n مجاني؟.
لو عايز فريق الـ HR عندك يبني الـ workflow ده بنفسه على وظايفكم الحقيقية، دي برامج تدريب الذكاء الاصطناعي للشركات: ورشة نص يوم، 3 ساعات أونلاين لحد 25 شخص، بـ 18,000 ج.م أو 1,200$، فيها الاستخدام الآمن للـ AI وأول workflow مبني قدامهم.
أسئلة شائعة
هل فيه برنامج فرز السير الذاتية جاهز بدل ما أبني واحد؟
فيه أنظمة ATS كتير فيها فرز. ميزة الـ workflow إنك إنت اللي كاتب الـ rubric وشايف الأسباب، والبيانات عندك.
الـ AI بيفهم CVs بالعربي؟
الموديلات الكبيرة بتفهم العربي والإنجليزي كويس. اختبر على 10 CVs حقيقية من عندك (بعد إذن أصحابها أو بعد شيل البيانات الشخصية) قبل ما تعتمد عليه.
ينفع الـ AI يبعت رفض للمرشحين أوتوماتيك؟
تقنياً ينفع، وأنا مش بنصح بيه. الرفض قرار، والقرار لازم يعدّي على إنسان.
الـ CV متصوّر ومش PDF نصي، أعمل إيه؟
إما تحوّله لمراجعة يدوية زي الـ workflow ده، أو تستخدم موديل بيقرا الصور. الطريقة دي مشروحة في مقال قراءة الفواتير بالذكاء الاصطناعي.