7 مشاريع بايثون للـ automation وفرت عليّا 95% من شغلي كل يوم
سنة 2021 كتبت 7 مشاريع بايثون للتقارير والشغل اللي كنت بعمله كل يوم بإيدي. حسب تقديري، المشاريع دي بقت بتعمل حوالي 95% من شغلي اليومي.
مشروع داخلي في شركة اتصالات عالمية. معروض هنا كنمط هندسي: الأرقام تقريبية، ومفيش اسم ولا بيانات ولا سكرين شوت من جوّه.
المشكلة
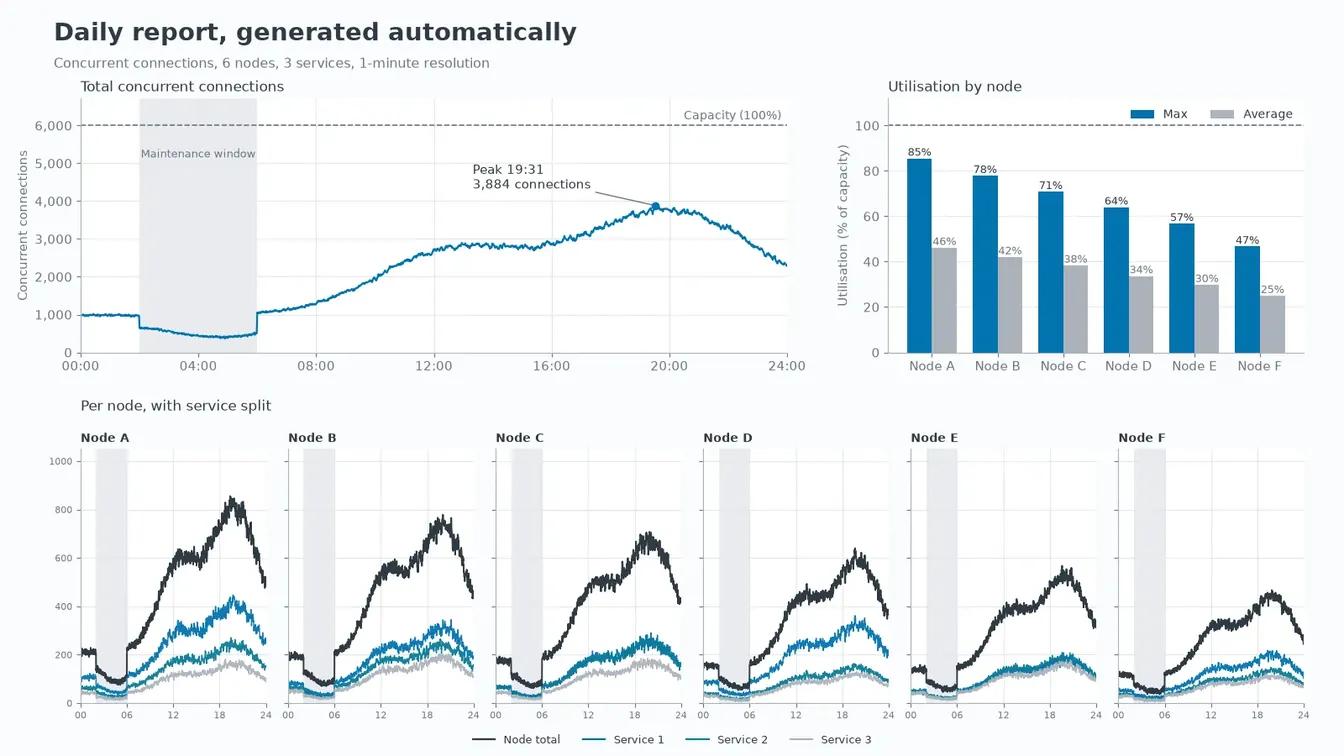
كل الـ charts في الصفحة دي متعادة الرسم ببيانات وهمية للتوضيح، ومفيهاش أي بيانات أو أسماء من الشغل الحقيقي.
كل يوم الصبح كنت بعمل كذا تقرير بإيدي. أهمهم كان بيبدأ إني أفتح SQL Developer وأشغّل query (طلب بيانات) على Oracle database. الـ query لوحدها كانت بتاخد من 30 لـ45 دقيقة، وبتطلّع لي حوالي 725,000 rows (صف). بعدها ساعة كمان في التحليل وتظبيط اتنين charts بس. يعني حوالي ساعتين كل يوم.
ونفس الكلام كان في باقي التقارير. أفتح أداة، أطلّع البيانات، أنقلها Excel، أحسب، وأرسم. نفس الخطوات كل يوم، والغلط وارد في أي واحدة فيهم.
إيه اللي اتبنى
مثال بالتفصيل: التقرير اليومي
كتبت Python script بيسحب بيانات اليوم من الـ Oracle database بـ SQLAlchemy (مكتبة Python بتكلم الـ database). بعدها بينضّف البيانات بـ pandas (مكتبة لتحليل الجداول): بيشيل الصفوف الفاضية والمكررة، وبيوحّد الأسماء والوحدات.
ده مثال مبسط للخطوة دي، بأسماء جداول وهمية:
import pandas as pd
from sqlalchemy import create_engine

engine = create_engine("oracle+cx_oracle://user:password@db-host:1521/?service_name=REPORTS")
df = pd.read_sql("SELECT * FROM daily_usage WHERE day = TRUNC(SYSDATE)", engine)

df = df.dropna()
df = df.drop_duplicates()
df["node"] = df["node"].str.strip().str.upper()
أول سطرين بيفتحوا اتصال بالـ database ويسحبوا بيانات النهارده في جدول pandas. الـ dropna بتشيل الصفوف الناقصة. والـ drop_duplicates بتشيل المكرر. وآخر سطر بيوحّد أسماء السيرفرات، عشان "node1 " و"NODE1" يتحسبوا واحد.
الـ script بيحلل فترتين كل واحدة لوحدها: فترة الصيانة بالليل من 02:00 لـ05:59، وباقي اليوم. لكل فترة بيطلّع أعلى نسبة استخدام، ووقت الذروة، وأكتر node (سيرفر) عليه حمل.
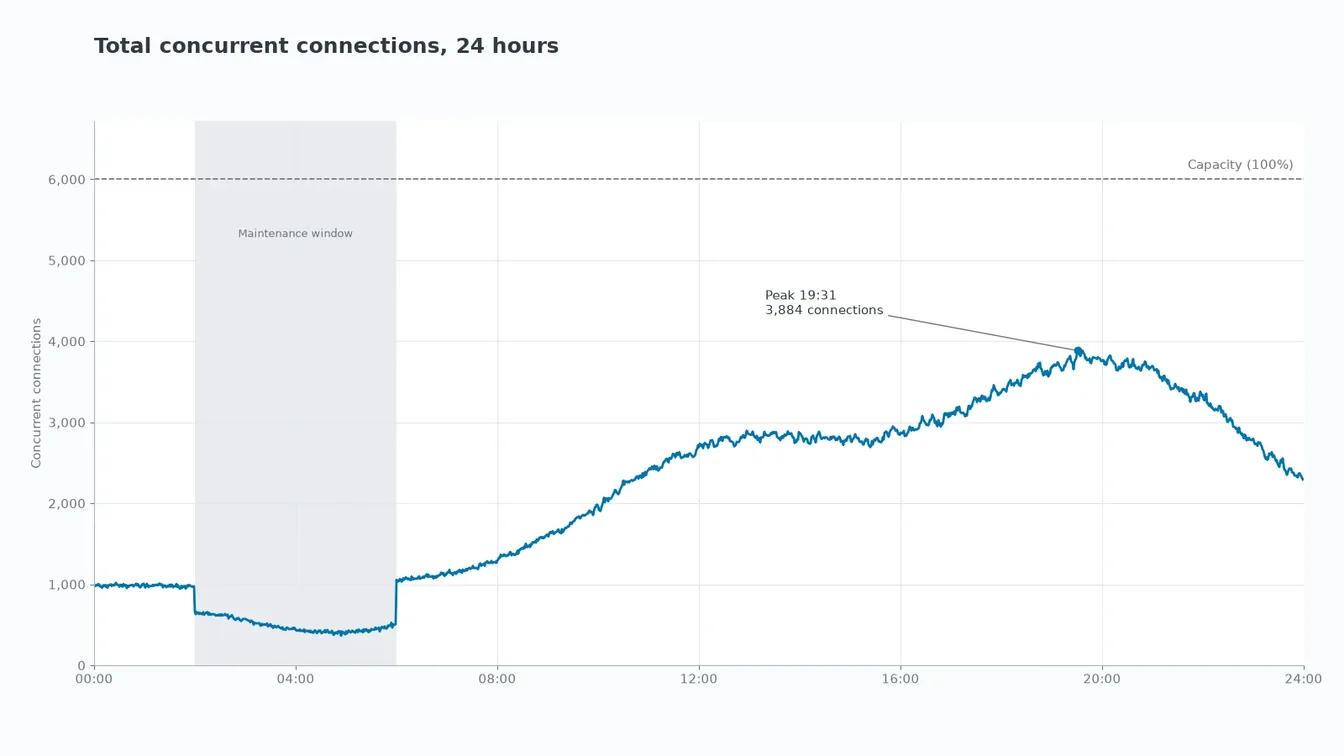
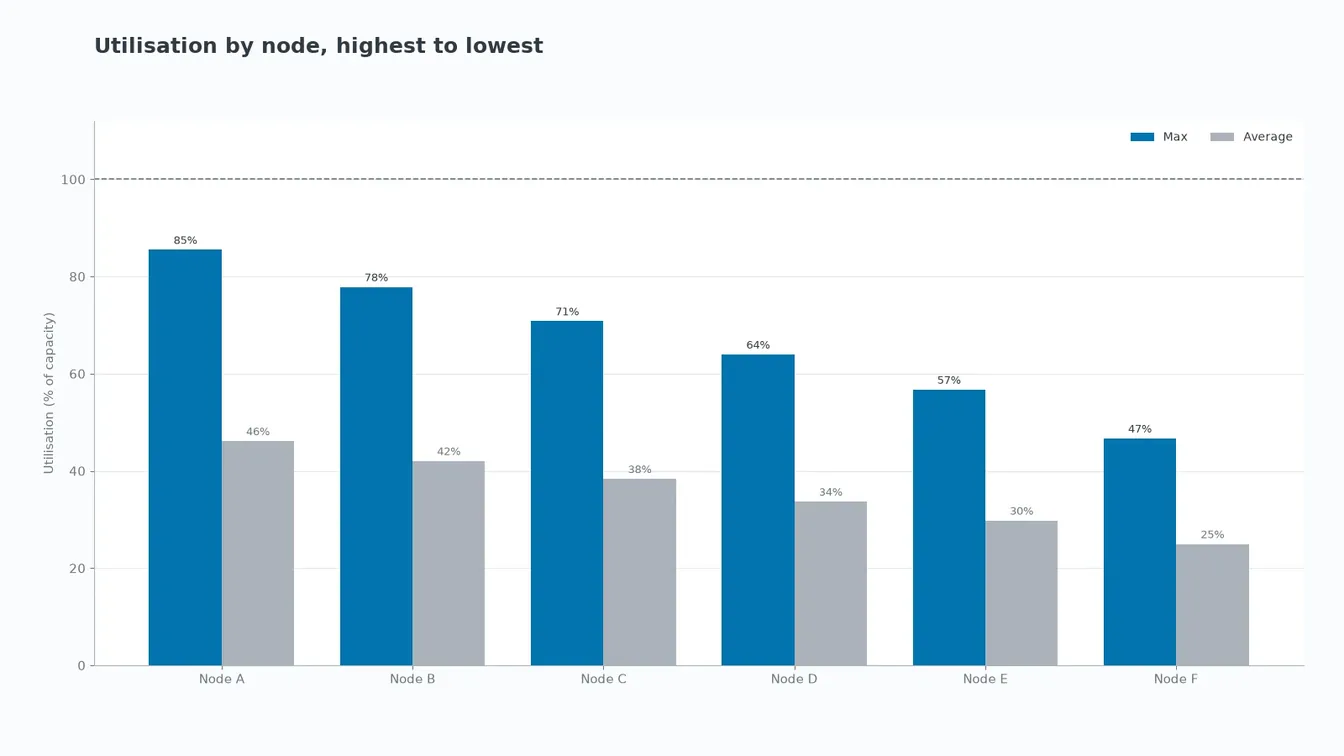
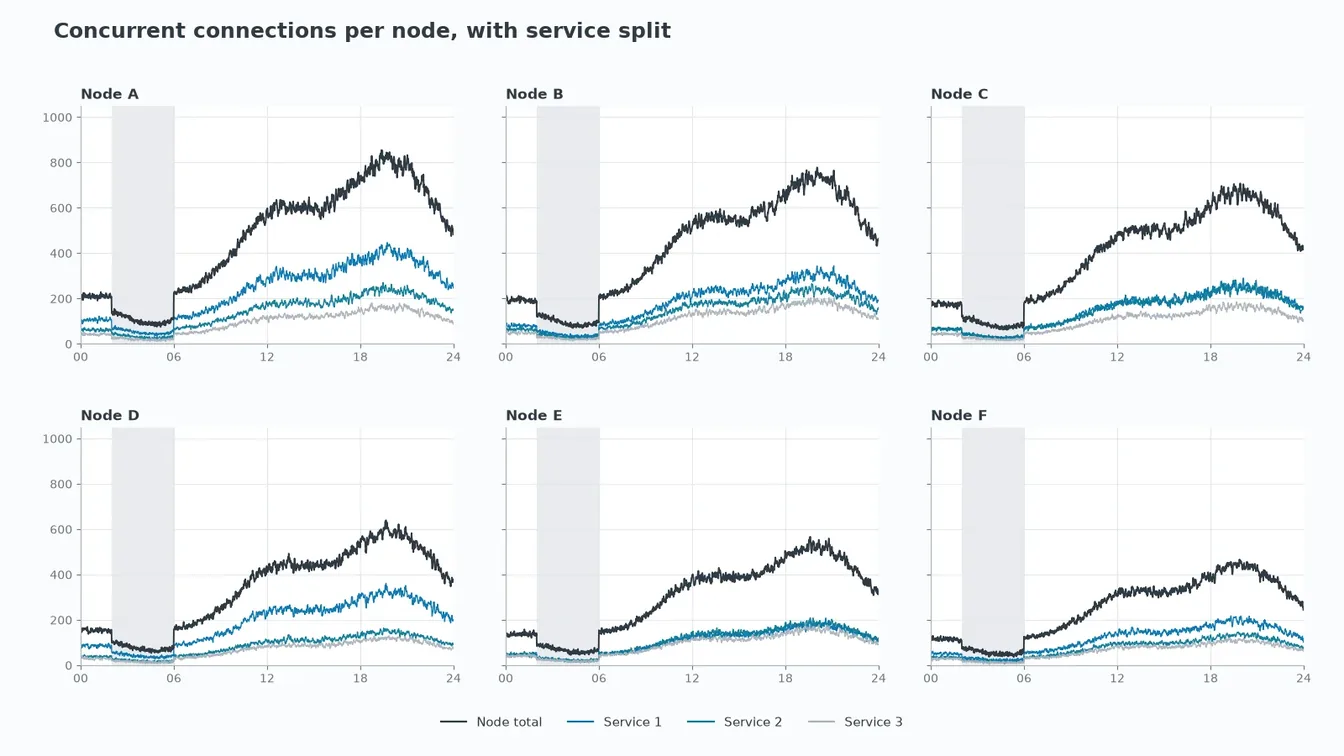
بعدها بيرسم أكتر من 50 chart بـ matplotlib (مكتبة رسم في Python): chart إجمالي لليوم، وbar charts مترتبة وغير مترتبة، وchart لكل node ولكل خدمة. وكمان بيكتشف المصادر اللي مبعتتش بيانات ويحطها في قايمة أراجعها، وبيحفظ نسخة CSV خام ونسخة متنضفة. التقرير اللي كان بياخد ساعتين بقى ضغطتين وأقل من 5 دقايق.
الـ 7 مشاريع بايثون بالتفصيل
1. التقرير اليومي من Oracle database
ده اللي شرحته فوق. من حوالي ساعتين لأقل من 5 دقايق، وفيه أكتر من 50 chart.
2. تقييم يومي من logs على Elasticsearch
الـ logs (سجلات النظام) كانت متخزنة على Elasticsearch (database للبحث في كميات كبيرة من السجلات). كل يوم كنت بدخل على Kibana (واجهة عرض الـ logs)، وأطلّع الـ traffic بتاع 3 مجموعات سيرفرات. بعدها أحسب بإيدي عدد الـ ports (منافذ الاتصال) اللي كل مجموعة محتاجاها. ده كان بياخد ساعتين على الأقل كل يوم.
المشكلة الأكبر كانت في Kibana نفسه. لو طلبت بيانات يوم كامل، كان بيديني بيانات كل 10 دقايق، حتى لو أنا طالب كل دقيقة. والـ Elasticsearch كان بيرجّع error لو البيانات كبيرة.
الـ script بيبدأ ببيانات كل دقيقة. لو جاله error إن البيانات كتير، بيزوّد دقيقة ويجرّب تاني لحد ما ينجح. وباقي التحليل بيتظبط على المدة اللي اشتغلت. كده بقيت بسحب بيانات كل دقيقة لآخر 4 أيام.
ده مثال مبسط للفكرة:
from elasticsearch import Elasticsearch, TransportError

def fetch_traffic(es: Elasticsearch, days=4):
    step = 1
    while True:
        query = {
            "size": 0,
            "query": {"range": {"@timestamp": {"gte": f"now-{days}d"}}},
            "aggs": {"traffic": {"date_histogram": {
                "field": "@timestamp", "fixed_interval": f"{step}m"}}},
        }
        try:
            return es.search(index="app-logs", body=query), step
        except TransportError:
            step += 1
الـ step هو المدة بين كل قراية والتانية، وبيبدأ بدقيقة. لو الـ Elasticsearch رفض الطلب، الـ script بيزوّد الـ step دقيقة ويطلب تاني. ولما الطلب ينجح، بيرجّع البيانات ومعاها الـ step اللي نجح، عشان باقي الحسابات تستخدمه.
الـ script بيطلّع أعلى traffic ووقته، وعدد الـ ports اللي كل مجموعة محتاجاها، وأكتر 10 عملاء عليهم حمل. وبيرسم ده كله في charts. التقييم اللي كان بياخد ساعتين بقى أقل من 5 دقايق.
3. نفس التقييم من غير ما حد يلمسه
بعد ما المشروع اللي فات اشتغل، فضلت خطوة واحدة: إني أشغّله أنا كل يوم. فعملت منه نسخة بتشتغل لوحدها على سيرفر في ميعاد ثابت. بتسحب البيانات، وتحسب التقييم، وتبعت email فيه التحليل والـ charts. التقرير بقى بيوصلني وأنا لسه داخل الشغل.
4. صورة واحدة للنظام من logs وجداول
عشان أشوف حالة نظام كامل، كنت بدخل على سيرفر Unix بعيد. أدوّر على ملفات logs متوزعة في أماكن مختلفة، وأنقلها على جهازي. بعدها أشغّل كذا SQL query على الـ database، وأدمج كل ده بإيدي. ده كان بياخد مني ساعات.
الـ script بيدخل على السيرفر بـ paramiko (مكتبة Python بتفتح اتصال SSH). بيدوّر على أحدث ملف من كل نوع بالاسم بتاعه، وبيسحبه. بعدها بيشغّل الـ queries، وبينضّف البيانات، وبيحلل استخدام الـ CPU والـ memory. وفي الآخر بيطلّع جدول واحد فيه حالة النظام كله. اللي كان بياخد ساعات بقى ضغطتين وأقل من دقيقتين.
5. مؤشر أداء يومي من مصدرين بيانات
كل يوم كان فيه جدولين كبار لازم أحسب منهم مؤشر واحد. كل قيمة في الجدولين كان لازم تتضرب في رقم بيختلف حسب نوع السيرفر. بإيدي ده كان بياخد ساعات. الـ script بيعمله في ثواني، وبيحفظ كل خطوة في ملف CSV عشان أراجعها.
بعدها أعدت كتابة نفس المشروع بشكل أنضف. الإعدادات بقت في ملف config لوحدها، فمبقتش بغيّر في الكود. وضفت logger (جزء بيسجّل كل خطوة الـ script عملها)، عشان لو حاجة وقفت أعرف وقفت فين.
6. تاريخ لعدد الـ pods على OpenShift
الـ OpenShift (منصة بتشغّل التطبيقات في containers) كان بيوريني عدد الـ pods (وحدات تشغيل التطبيقات) دلوقتي بس. ومكانش فيه تاريخ للـ limits، والفرق كانت بتغيّرها من وقت للتاني. فمكنتش أقدر أعرف كل خدمة محتاجة كام pod في وقت الذروة.
كتبت ETL pipeline (بيسحب البيانات ويجهزها ويخزنها). كل 15 دقيقة بيقرا عدد الـ pods والـ limits لكل خدمة. وبيضيف الوقت، ويخزن صف جديد في جدول على Oracle database. ومع الوقت بقى عندي تاريخ كامل أقدر أحلله. الفكرة بسيطة: لو الشاشة بتوريك اللحظة دي بس، اعمل التاريخ بنفسك.
7. أداة رسم معمولة مخصوص
في الـ chart العادي، القيم الكبيرة القليلة بتخلي باقي النقط متكومة في ركن، ومتتقريش. عملت أداة رسم بتقسم الرسمة عند حد أنا بحدده. القيم العادية بتترسم بحجمها الحقيقي. والقيم الكبيرة بتتصغر عشان تبان في نفس الرسمة. كده بقيت أقرا قيم كتير مرة واحدة.
اتكتبت سطر سطر قبل أدوات الـ AI
المشاريع السبعة اتكتبت سنة 2021، قبل ما يبقى فيه AI بيكتب code. لما برجع أقرا الـ code اللي كتبته بإيدي سطر سطر، مبحسش إنها مشاريع ضخمة. دلوقتي ممكن تتعمل بسهولة. بس في رأيي هي دي اللي عملت خبرتي: قراية الـ documentation، وإني أمشي في الـ SDLC كله، والـ debugging لحد ما ألاقي سبب الـ error.
إزاي تبدأ مشاريع python automation بنفسك
دي أهم حاجات اتعلمتها من المشاريع دي:
- ابدأ بالشغل اللي بتكرره كل يوم. كل المشاريع السبعة بدأت من تقرير كنت بعمله بإيدي، مش من فكرة جديدة.
- اتعلم pandas الأول. أغلب الشغل كان تنضيف جداول ودمجها، و pandas بيعمل ده في سطور قليلة.
- اكتب الـ script يشتغل مرة، وبعدين خليه يشتغل لوحده. التقييم من Elasticsearch بقى script بشغّله، وبعدها بقى email بيوصلني.
- خلّي الـ script يحفظ كل خطوة. نسخة CSV خام ونسخة متنضفة بتخليك تراجع الأرقام من غير ما تعيد الشغل.
- حط الإعدادات برا الكود. ملف config و logger بيوفروا عليك وقت كبير لما حاجة تتغير.
النتيجة
حسب تقديري، المشاريع دي بقت بتعمل حوالي 95% من شغلي اليومي.
اتعلم تبني زيه: المحاضرات3،6في الدبلومة
بالأرقام
شارك المشروع
عايز زيه؟ الخدمة اللي بتبنيه
أوتوميشن سريع
شغلانة بتاكل وقتك كل أسبوع، تبقى workflow شغّال في 10 أيام
مناسبة لـ: في شغلانة بتعملها كل يوم أو كل أسبوع بنفس الخطوات
يبدأ من15,000 ج.مأو $1,200 للدفع من خارج مصر
7 لـ 10 أيام